面试真题:存储20 亿手机号,MySQL 选 INT 还是 VARCHAR?
- 2026-11-19 10:22:04
面试被问到一道题:如果要存 20 亿条手机号,数据库字段选 int 还是字符串,char 还是 varchar?
很多人下意识会选 int,觉得手机号全是数字,用整型最节省存储空间。但这个想法从一开始就不对。
国内 11 位纯手机号优先用 BIGINT UNSIGNED,INT 直接排除,存不下;CHAR(11) 虽然能用,但存储空间不占优势;如果需要存储国际号码、要做号段前缀模糊查询,再选用 VARCHAR(20)。
判断的核心:手机号是用来识别、匹配的编号,不是用来做数学计算的数字。
01 为什么 INT 完全不能用
有符号 INT 最大值是 2147483647,无符号 INT 上限 4294967295。
国内手机号以 1 开头,总共 11 位,最小的号码也有 10000000000,已经远超无符号 INT 的上限。
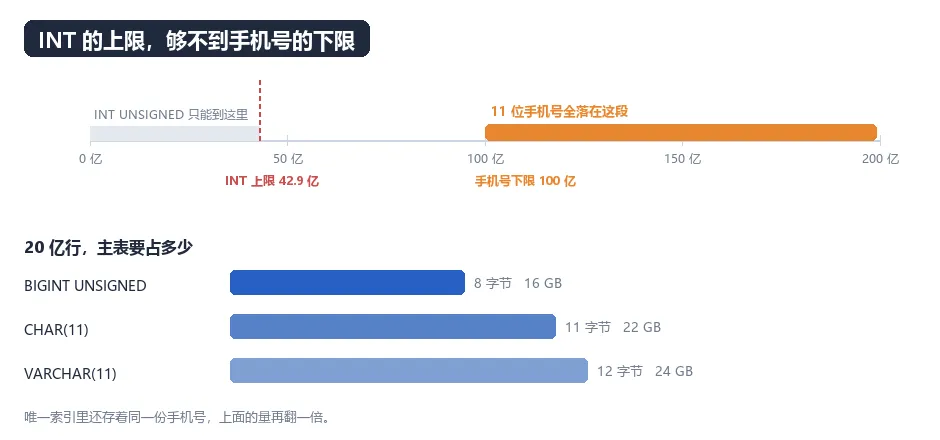
如果强行往 INT 字段写入手机号,会直接报 Out of range value for column 'phone' 数值越界。
所以“用 int 省空间”在手机号这个场景根本不成立,整型里面只有 BIGINT 可以胜任。
CREATETABLE user_phone ( id BIGINT UNSIGNED NOTNULL AUTO_INCREMENT, phone BIGINT UNSIGNED NOTNULL,PRIMARY KEY (id),UNIQUE KEY uk_phone (phone)) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;02 BIGINT、CHAR、VARCHAR,字节差距被索引放大
三种字段单行以及 20 亿行主表的占用情况:
VARCHAR 多出的 1 字节是长度前缀。这里有个不少人记错的知识点:CHAR(11) 在 utf8mb4 字符集下,并不会无脑预留 44 字节空间,存纯数字实际只占 11 字节。
真正的存储消耗大头来自索引。我们给 phone 建立唯一索引 uk_phone,索引内部会完整保存 phone 字段。主表每一行差 3 字节,索引同样差 3 字节。20 亿条数据叠加下来,总差距可以达到十几 GB。
并且索引 key 越短,InnoDB 一页能够存放的索引条目就越多,B+ 树高度更低,查询性能也会更好。
03 20 亿数据,单表根本扛不住
单表 20 亿行,不管是写入、DDL 变更还是备份,都会遇到严重性能瓶颈。
实际业务会对手机号做 hash 取模,拆分成 64 或者 128 张子表。手机号分布比较均匀,不容易出现热点分片。
但分表也带来约束:查询必须带上手机号,才能直接路由到对应分片。
像运营后台按注册时间分页、按城市做统计这类场景,就不能直接查询这组分表,需要依靠离线数仓或者 ES 来完成。
还有一个很关键的坑:如果把手机号存为 BIGINT,就无法直接做号段前缀查询。
LIKE '138%' 这类号段筛选,需要先把数字转为字符串,会直接导致索引失效。
选型总结
只存国内 11 位手机号,只有等值查询:BIGINT UNSIGNED 需要存 +86 国际号码、号段前缀查询、保留前置零:VARCHAR(20),字符集建议设置 ascii
手机号本质是业务编号。选用大整型,目的是节省存储,不是拿来做加减乘除算术运算。