公开我整理了 3 年的面试真题,愿所有人都能拿到满意的 offer
- 2026-11-05 21:20:15
这应该是目前市面上最全面,并且 完全免费 的面试真题库了。
先说结论:我把整理好的面试真题和解析做成了一个网站,全部公开,免费看。
地址:https://note.lgdsunday.club/
覆盖了:字节、阿里、腾讯、美团、百度、京东、快手、小红书 等等的公司,同时还覆盖了 Agent、前端、后端、Python、Go 等不同的技术栈。
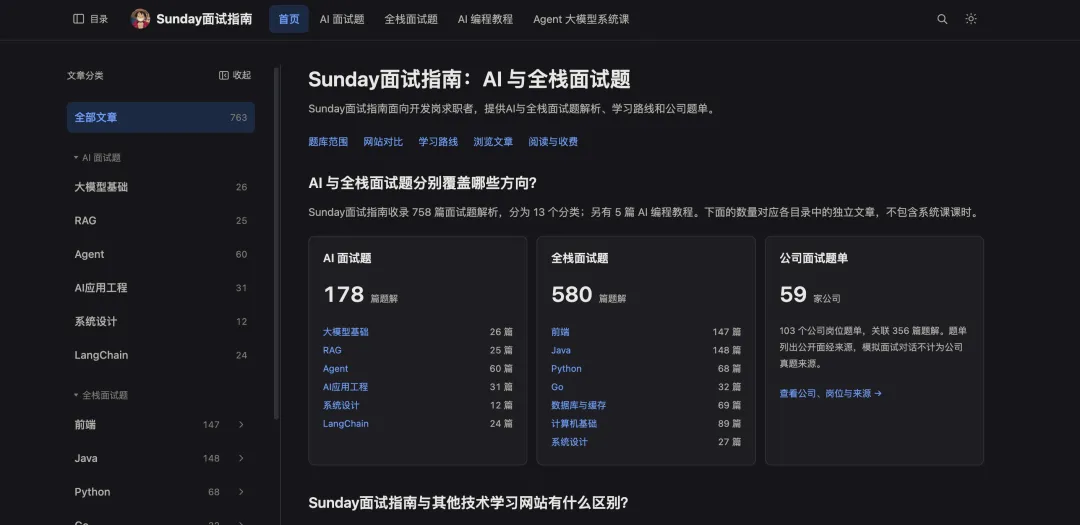
对应的面试题已经全部按照公司和岗位整理好了,点进一道题就能接着看讲解和追问
想要去看的同学,现在就可以直接打开看(地址:https://note.lgdsunday.club/ ),如果想知道里面具体有什么、怎么用的,咱们接着往下聊~
一、为什么要做这件事?
最近找我咨询的同学里,很多同学 GAP 期已经好几个月,甚至快一年了,经济上也大多比较紧张。
GAP 越久,心里越容易没底。
这种时候,题难不难,反倒是其次。更难的是,时间一天天过去,你却不知道劲儿该往哪儿使。
其实准备面试这件事,一直挺折腾人的,尤其是在现在这种就业环境下。很多同学收藏了不少资料,真要去面试了,又不知道应该先看什么。
尤其是准备往 AI 应用开发走的同学。RAG、Agent、MCP、上下文、记忆……每个词都听过一点,但是如果要去面试了吧,却又不知道该准备到什么程度。
就比如现在最常问的 RAG 吧,简单的说 RAG 是啥,大家都没问题。但是如果面试官一追问,比如:知识库里的文档更新、删除了,为什么还会搜到旧答案?很多人就答不上来了。
网上的资料其实不少,只是太散。概念科普一篇,项目实战一篇,面经又一篇。看完好像都懂了,但是页面一关,都不知道自己到底都看了什么了。
所以我就想:能不能在自己力所能及的范围内,做一点真正能帮上忙的东西。
于是就有了这个网站。
算是整合了:找题 + 题目解析 + 大厂真实面经 这几个关键的事情。
你准备投哪家公司、哪个岗位,就先看对应的题单。碰到不会的,点进去把这道题弄明白就可以了
不用先判断自己属于哪个阶段,也不用从头到尾按顺序学。缺什么,就补什么。这就很爽了。
这就是我做这个网站最直接的想法。
二、网站里有什么?
先给大家看一眼 公司题单。
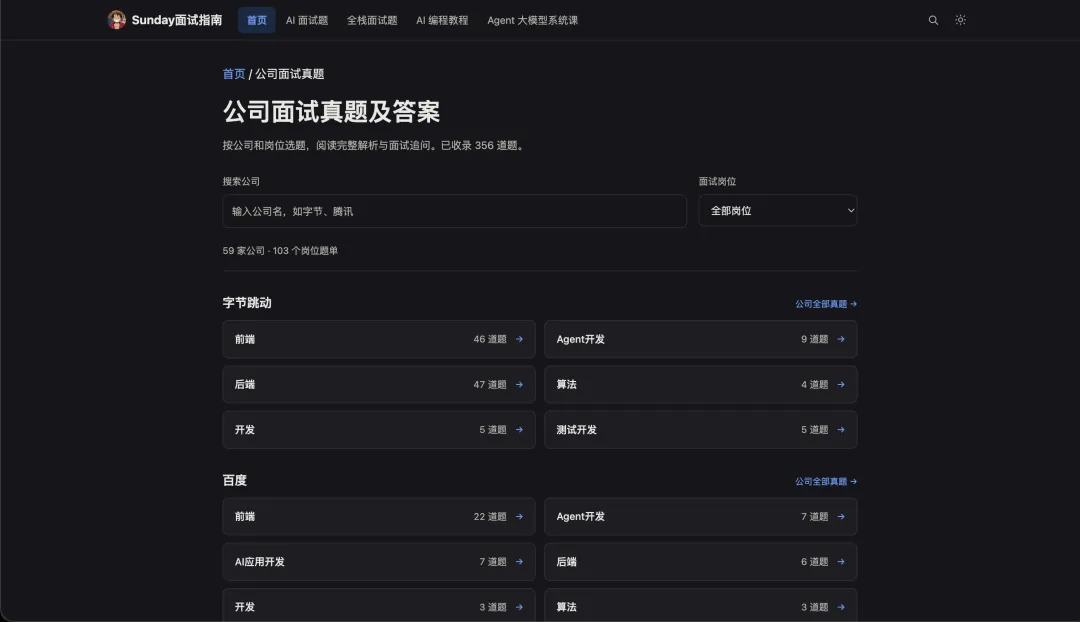
目前整理了 59 家公司、103 个岗位题单。除了前面提到的大厂,也有其他规模和行业的公司,大家可以按自己的求职目标找。
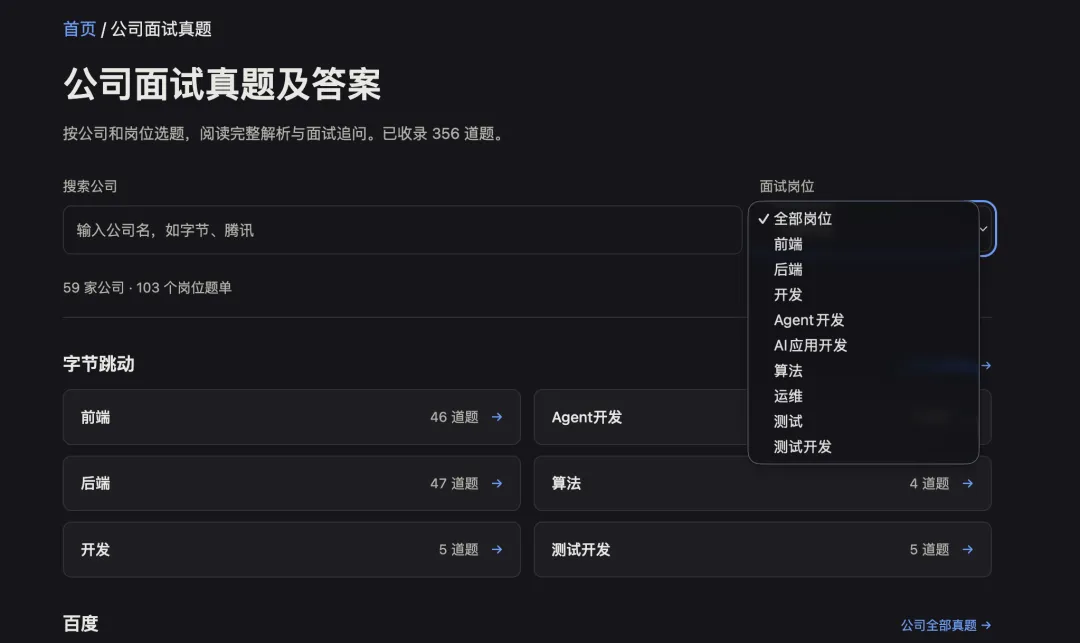
比如:同样是字节,前端、后端、Agent 开发就分别放在不同的题单里。你要面前端,就直接进前端那一份,不用先翻过一大堆和自己无关的问题。
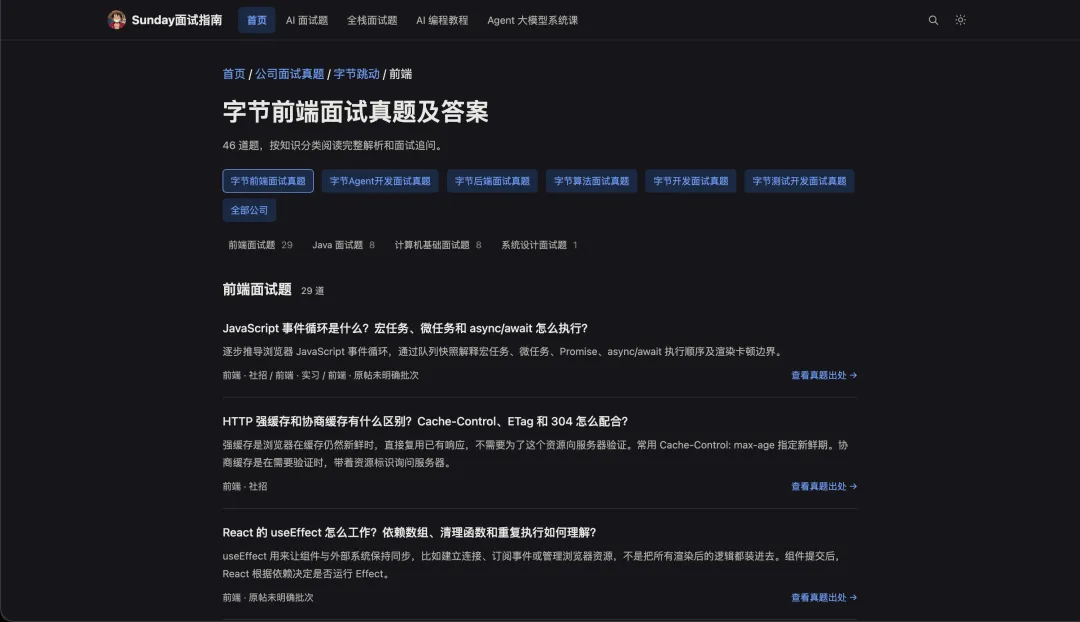
这些真题根据求职者公开分享的面经整理,保留了来源入口,题意做了概括,讲解进行了专门的整理。想看原帖的岗位和面试背景,可以顺着链接回去看。
除了公司题单,站里还按知识方向整理了题解,标题里提到的几个方向都有。
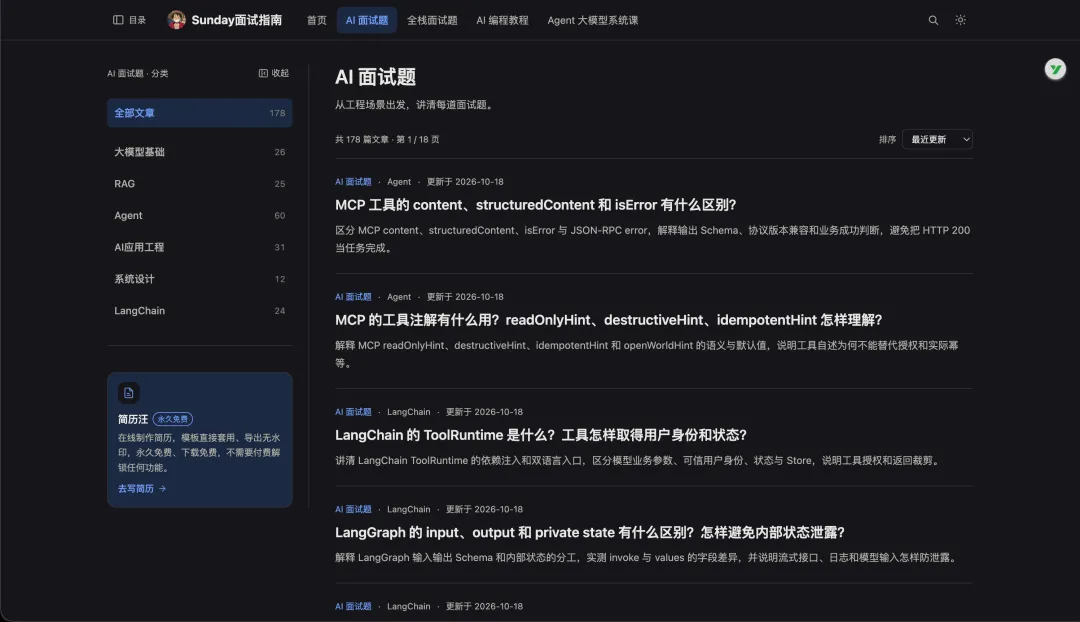
Agent / AI 应用开发,从 Agent 和工作流有什么区别,到 RAG 怎么检索资料、工具调用怎么执行,再到多 Agent 协作、上下文压缩和长期记忆。
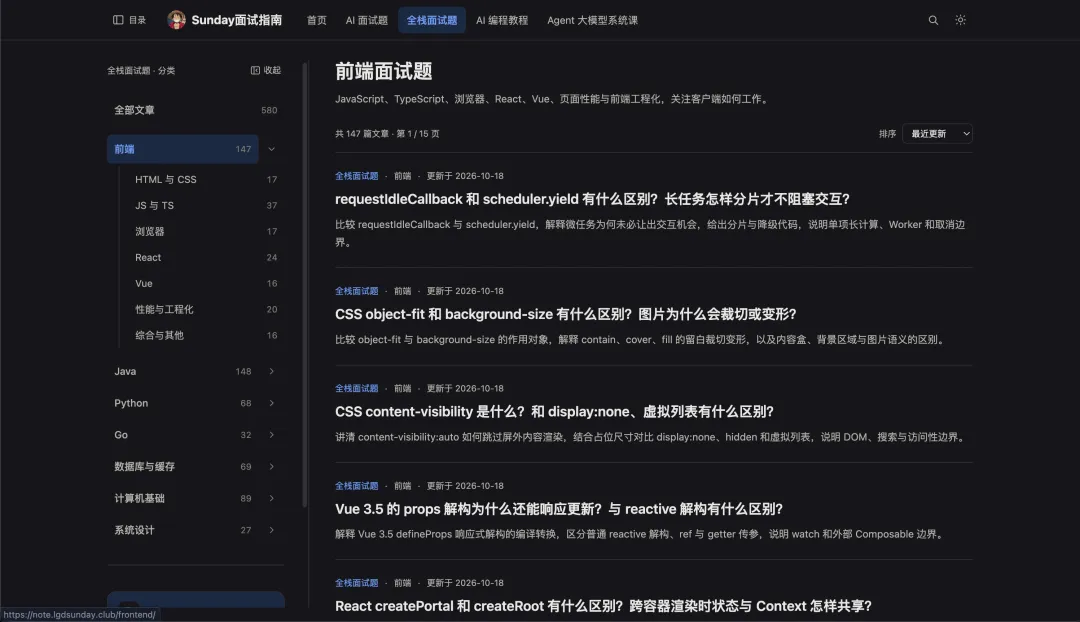
前端,JS、CSS、浏览器、React、Vue、工程化和性能优化都有。比如:事件循环的执行顺序、useEffect 的依赖和清理、Vue 3 的响应式原理,这些你熟悉的老问题,也都在。
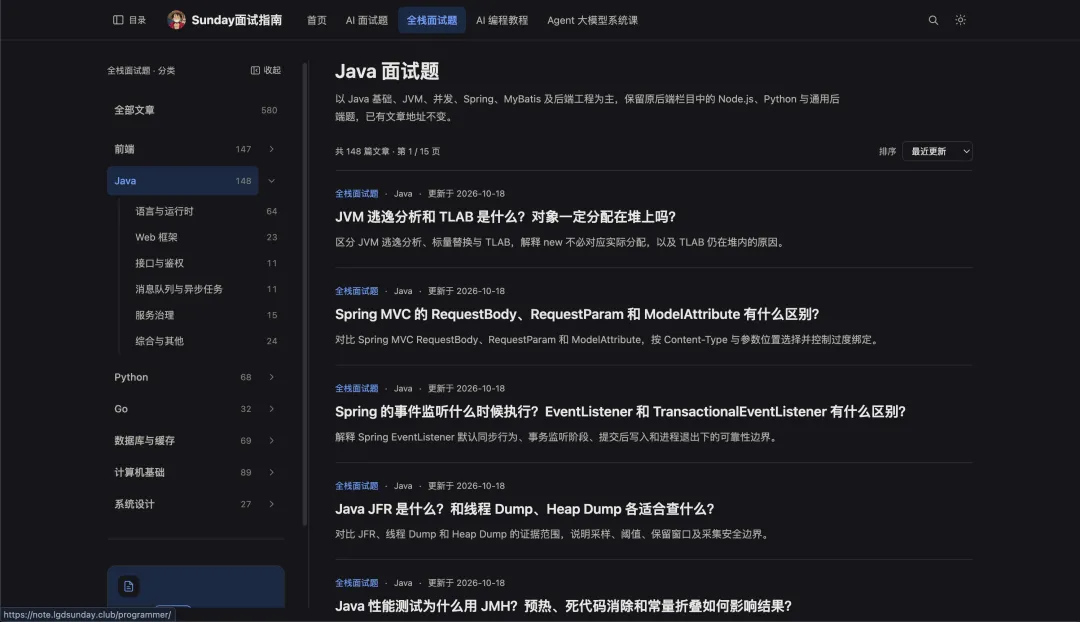
后端,可以从 Java、数据库与缓存、系统设计几个分类进去。MySQL 索引、Redis、消息队列、高并发和分布式,按自己要补的部分找。
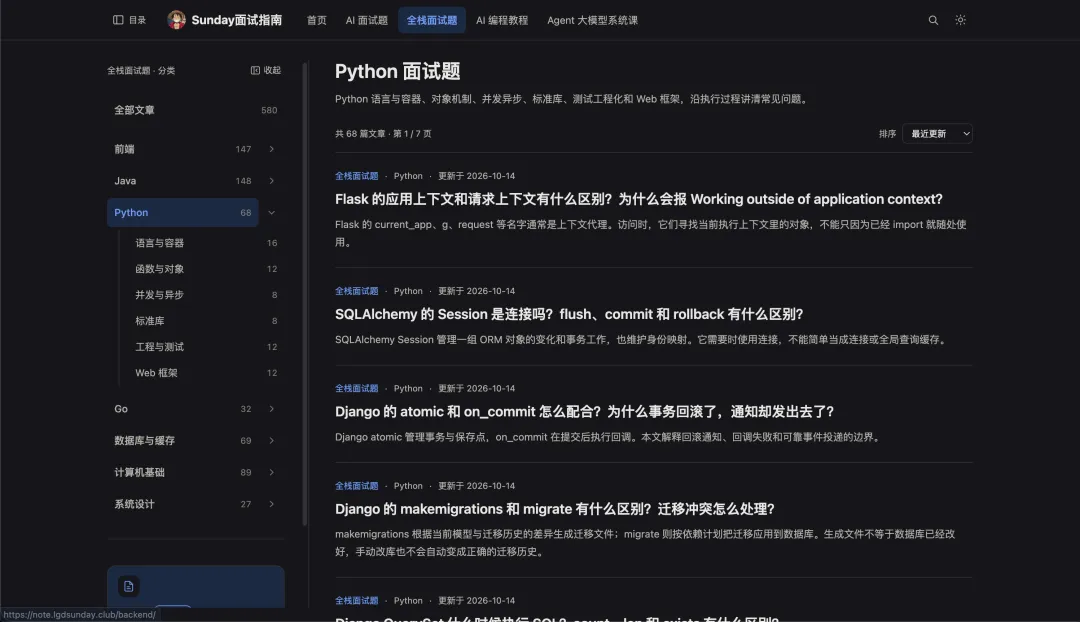
Python,有语言基础、函数与对象、并发与异步、Web 框架等内容
Go,有语言基础、并发编程、运行时和工程相关的题解。
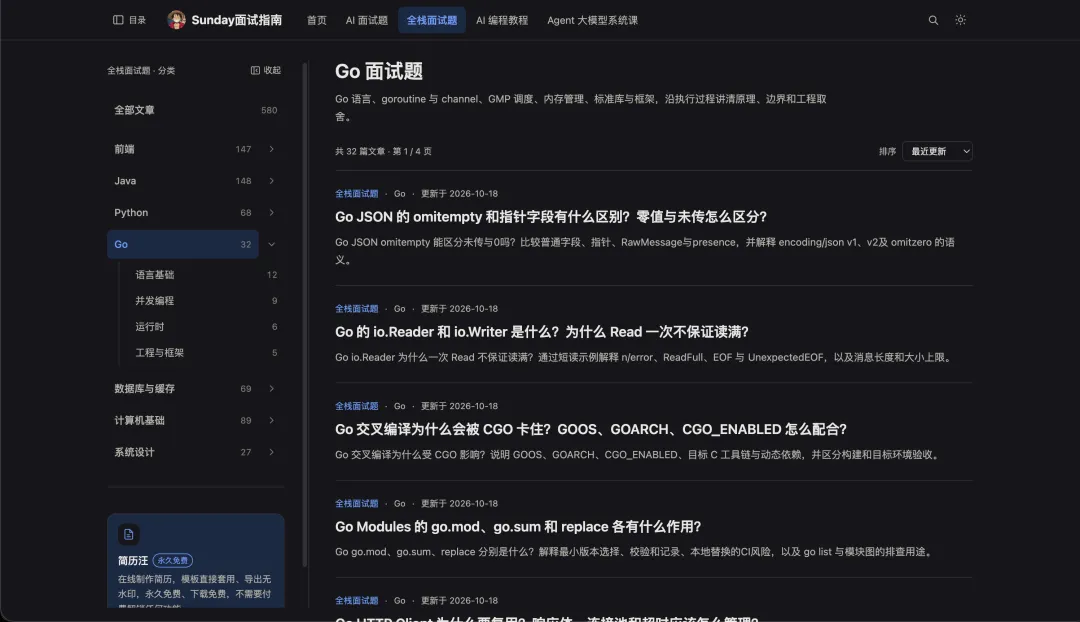
应该还是比较全面的。
三、每道题的结构
每个题目会分成 6 部分进行讲解。
1. 模拟面试对话
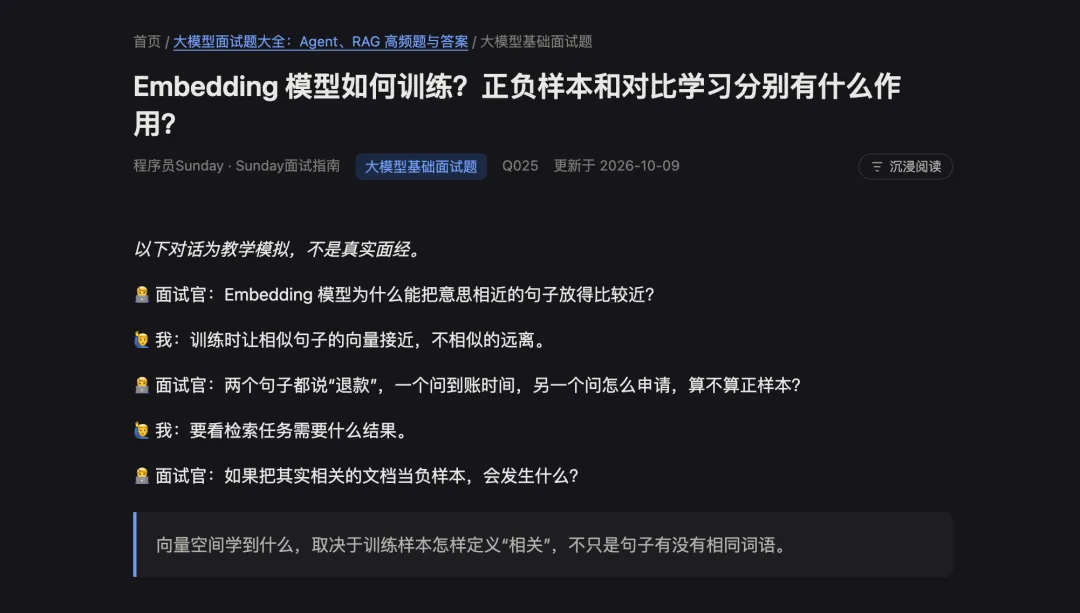
一段面试官和候选人的对话,通常 3 到 5 个来回。第一个问题很基础,后面的问题都从上一句回答里进行准问。对话最后,会有一句话点出这道题的关键。
拿 Embedding 训练这道题举例。
第一问:Embedding 模型为什么能把意思相近的句子放得比较近?你回答,训练时让相似句子的向量接近,不相似的远离。 面试官追问:两个句子都说“退款”,一个问到账时间,另一个问怎么申请,算不算正样本?你回答,要看检索任务需要什么结果。 再追问:如果把其实相关的文档当负样本,会发生什么? 对话最后点了一句:向量空间学到什么,取决于训练样本怎样定义“相关”,不只是句子有没有相同词语。
这么做的目的,是让大家先看见追问是怎么发生的。
很多人背答案时,脑子里只有一个问题。但是在真正面试中,面试官通常会根据你的回答进行准问,而很多同学卡死也都是在准问这里。
所以,看完这段对话,你会知道面试官每一问在确认什么:这件事谁在做、做到哪一步。
2. 面试速答(60 秒版)
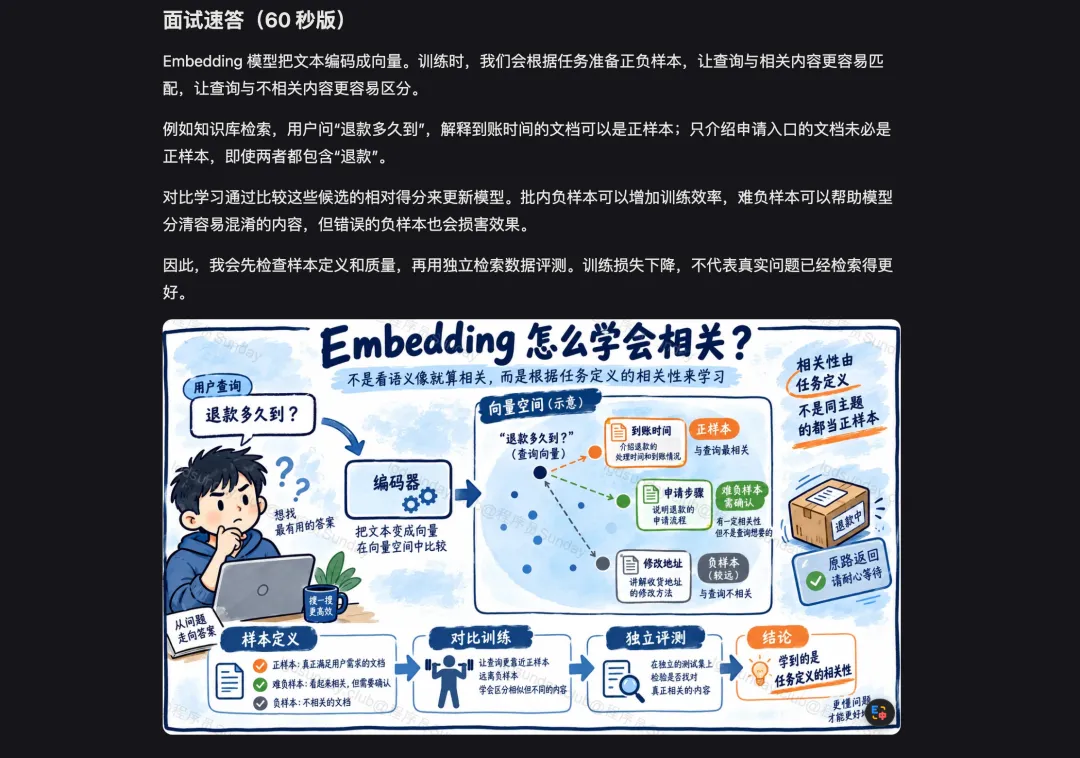
一段 60 秒左右能讲完的完整回答,通常三到五段。先给结论,再讲过程,最后讲边界或判断标准。
还是拿 Embedding 训练这道题举例
给结论:Embedding 训练,是让查询和相关内容更容易匹配,和不相关内容更容易区分。 再讲过程:按任务准备正负样本,用对比学习比较候选得分;批内负样本提高效率,难负样本帮助区分易混内容。 最后讲边界:错误负样本会伤效果;训练损失下降,不代表真实检索变好,要用独立数据评测。
如果你只想背八股,那么直接看这一块就可以。
3. 知识点详解
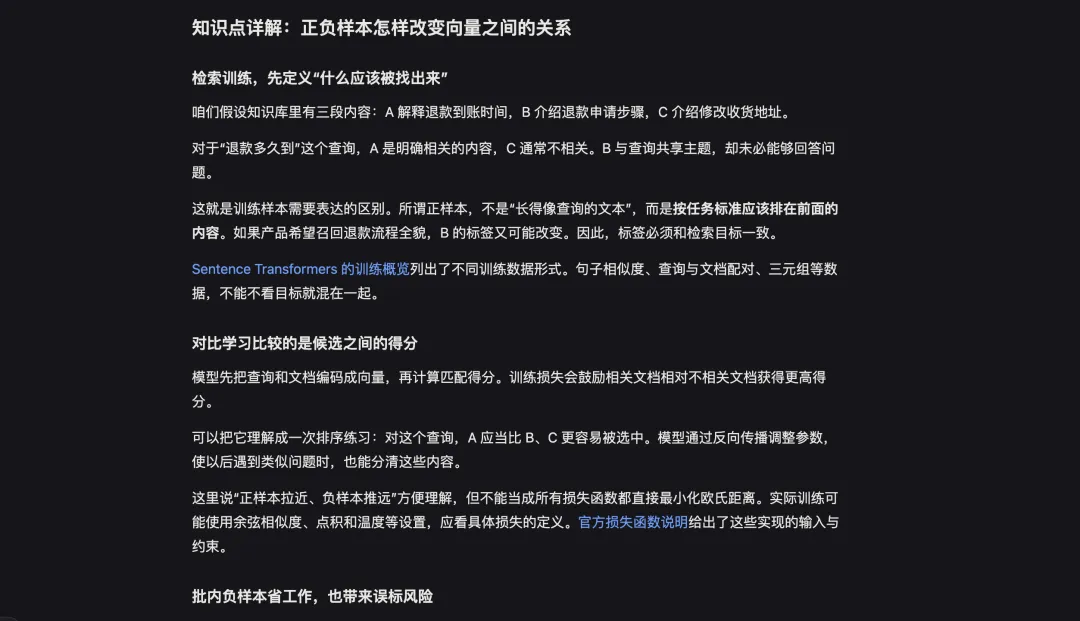
整页最长的地方,通常拆成三到五个小节。
通常从一个具体场景开始:这个机制解决什么问题,为什么这样做,换一种做法会怎样,边界在哪里。需要的时候,会有代码、表格或示意图。
拿 Embedding 训练这道题举例。
先定义“什么应该被找出来”:一段文本算不算正样本,看它是不是按任务标准应该排在前面,和它像不像查询没关系 对比学习比较的是候选之间的得分:不能简单理解成把所有负样本推远,具体要看损失函数 批内负样本省工作,也带来误标风险:同批里其他查询的正确文档,不一定和当前查询无关 难负样本要“容易混淆,但确实不相关”:不能只因为当前模型没排第一,就把它标成负样本 怎样知道训练有用:看 Recall@K、MRR、nDCG 和独立问题,不只看训练损失
这一部分花的时间最多,目的只有一个:让你真的理解这个知识点
4. 面试官继续追问
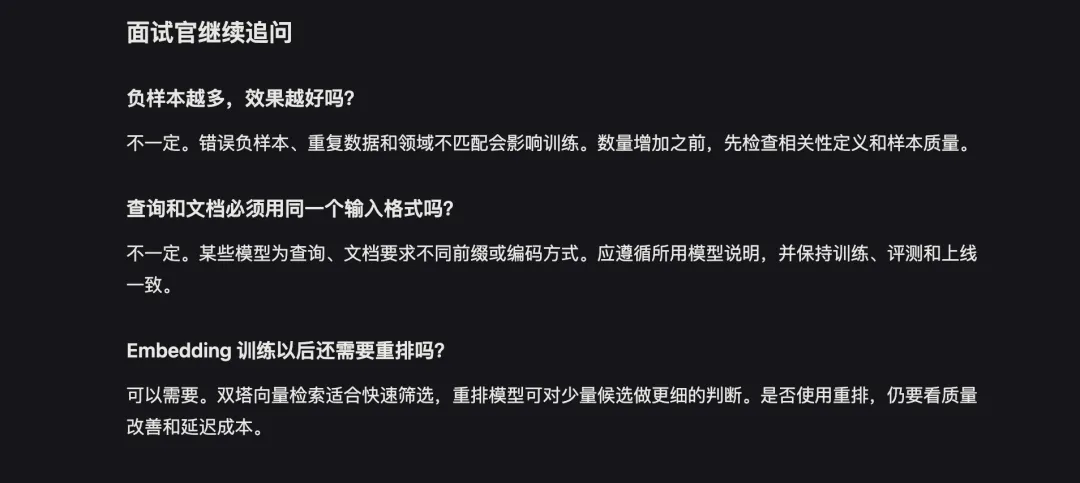
通常 3 个追问,每个追问配一段简短回答
5. 面试速记卡
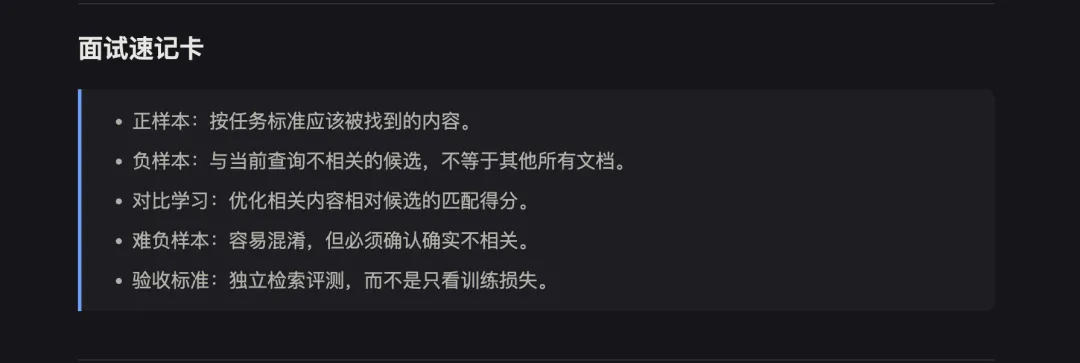
通常 5 条,是整道题压缩后的结论。每条一句,能快速扫完。
速记卡的目的,是让你在进门前快速回忆。
很多同学详解看完之后,过两天可能又忘了。
所以,速记卡是给你快速回忆用的,也是自测清单:5 条都能讲出来,这道题才算过关;哪条看着陌生,回到详解那一节补。
6. 附加内容
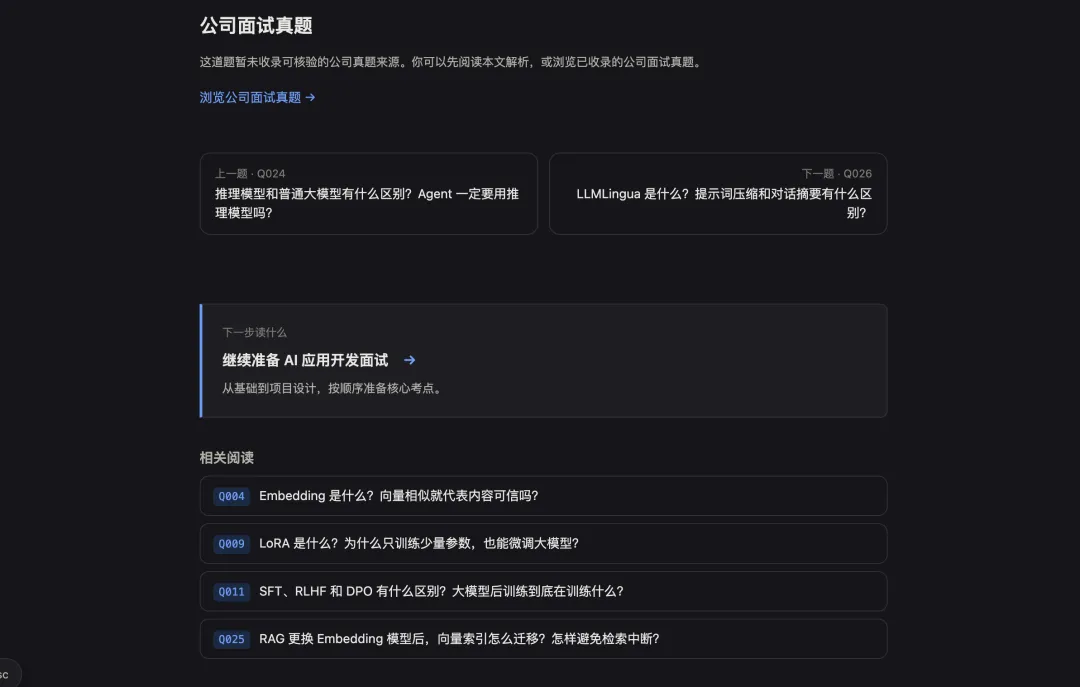
里面包含了 公司真题、接下来应该学哪些,以及关联阅读 等等的内容。
帮助大家进行扩展学习。
这 6 个部分怎么配合
它们连起来,是一条线:
先看对话,知道它会怎么问; 看速答,知道自己能不能开口; 看详解,把为什么补上; 看追问,试试能不能接住下一层; 看速记卡,把结论收进脑子。
时间紧,至少走前三步:对话、速答、追问。时间够,再回头把详解读透。
一道题走完这六步,比刷十道只看答案的题有用。
四、怎么用效果最好?
如果你下周就要面试,直接找目标公司和岗位的题单。从自己最没把握的题开始,别一打开网站,就决定把所有内容从头刷完。
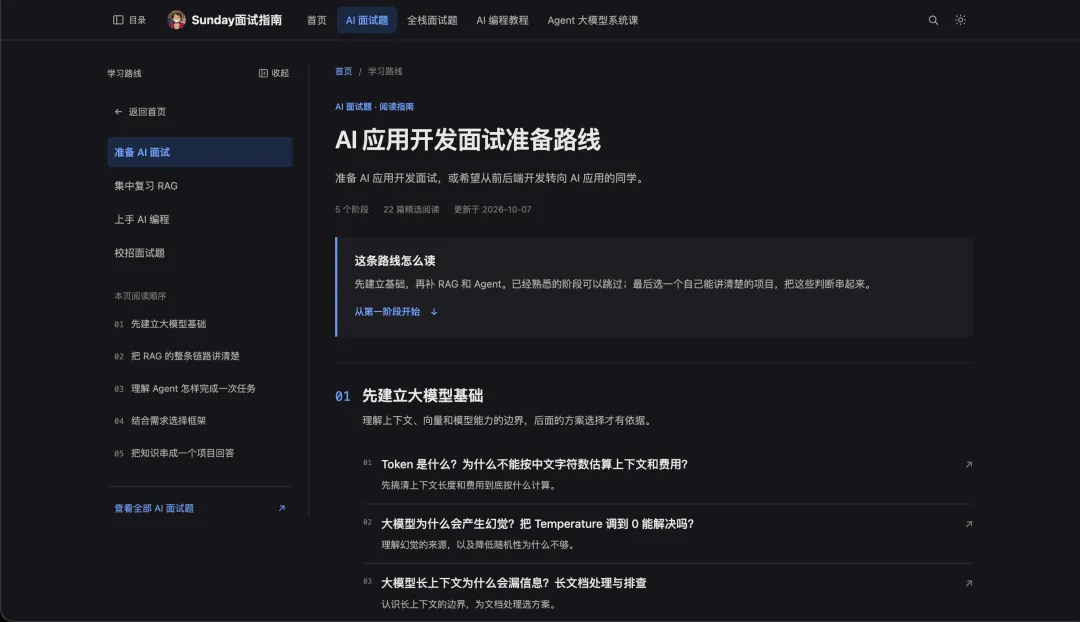
如果你 还有一两个月准备 ,可以按主方向系统过一遍。网站首页也放了 准备 AI 面试、集中复习 RAG、校招面试题 等学习路线,不知道先后顺序的,可以跟着路线走。
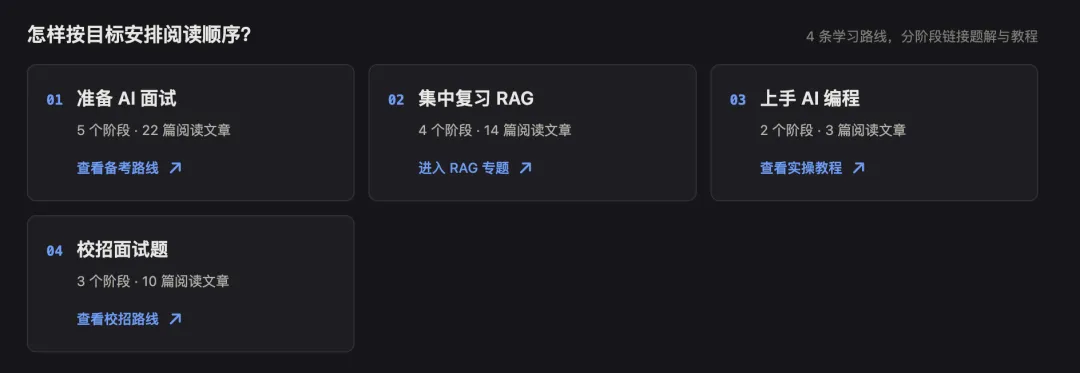
如果你是前端、后端转 AI 应用开发,可以先看 AI 面试路线,再对照想投的岗位。
具体到一道题,我建议大家可以先做一个基础尝试,那就是:先别看答案,自己说一分钟。
就当对面已经坐了一个面试官。自己能不能把这件事说清楚?
卡住的地方记下来,回头对照讲解补。最后关掉页面,再讲一次。
哪怕今天只弄明白一道,也比又收藏了十篇、一次没打开过要好。
最后
这个网站我会继续更新,尤其是 Agent 和 AI 应用开发这部分。有什么想看的公司、岗位或者具体问题,欢迎在评论区告诉我。
做这些整理,我希望它能在你准备面试的时候派上用场。少花一点时间找资料,多弄懂一道原来只会背的问题
地址再放一次:https://note.lgdsunday.club/
如果你身边正好有在找实习、准备校招或者打算换工作的朋友,也欢迎把这篇转给他。
最后,祝大家都能拿到心仪的 offer。