百度 9 月 Java 面试真题复盘:ThreadLocal 深
- 2026-09-19 15:20:58
百度 9 月 Java 面试真题复盘:ThreadLocal 深挖 + AI 项目加持
大厂真题系列第七期,百度。
百度有两个很鲜明的标签:一个是 AI(文心一言、大模型),另一个是基础功底的"深挖式"提问。
从面经看,百度一面会把一个知识点挖到底层。最典型的是 ThreadLocal——它能连问你四层:实现原理是什么?ThreadLocalMap 的 key/value 是什么引用类型?为什么 key 能被 GC 回收但 value 不能?线程池场景怎么办?
而二面则是"项目 + 场景",还会专门问 AI 相关的项目(百度的 AI 基因)。
一、ThreadLocal 连环问:百度的"招牌深挖题"
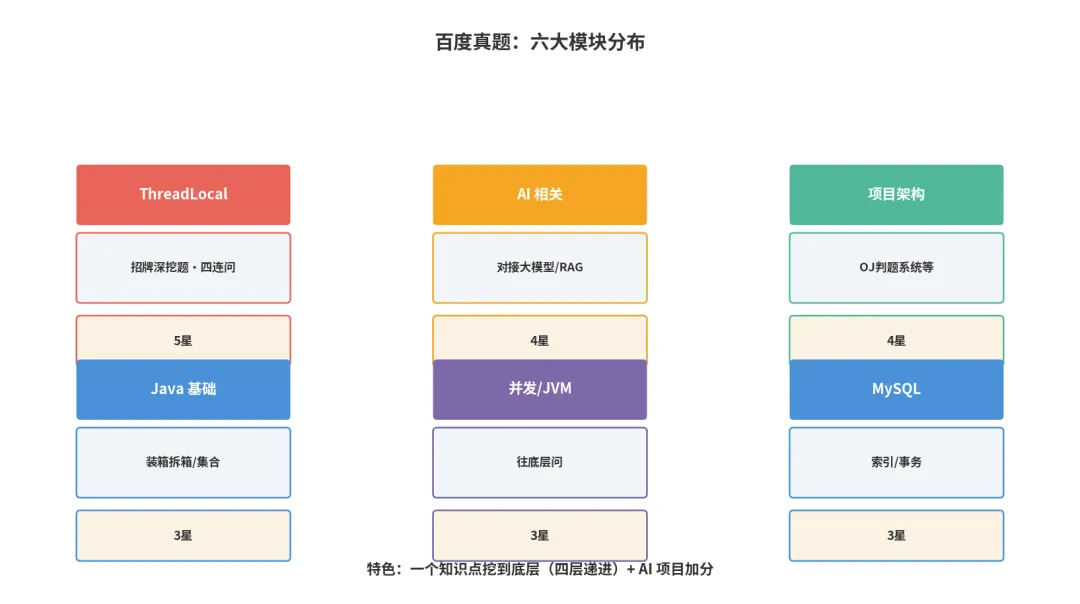
这道题在百度面经里出现频率极高,而且是层层递进的四连问。
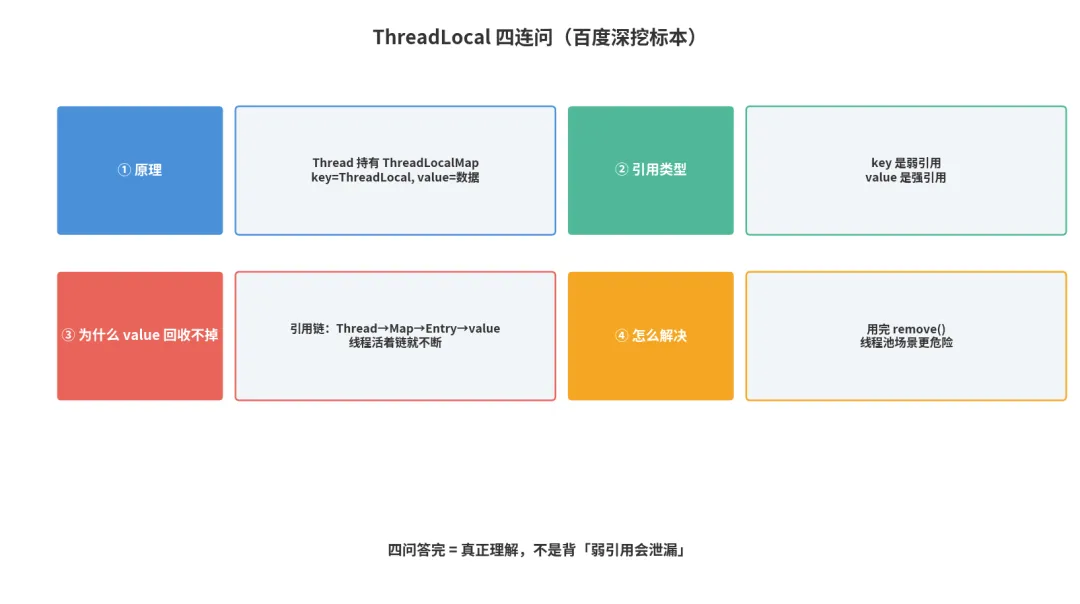
第一问:ThreadLocal 的实现原理?
答案要点:每个 Thread 内部有一个 ThreadLocalMap(不是 ThreadLocal 持有数据,是 Thread 持有)。ThreadLocal 作为 key,值作为 value 存在这个 map 里。所以数据是"线程私有的",各线程互不干扰。
第二问:ThreadLocalMap 的 key 和 value 是什么引用类型?
答案要点:key 是 ThreadLocal 对象,是弱引用(WeakReference);value 是你要存的数据,是强引用。
第三问:为什么 key 能被 GC 回收,但 value 不能?
答案要点:这是最关键的一问。
key 是弱引用,当 ThreadLocal 对象没有强引用指向它时,GC 会回收它,此时 map 里的 entry 变成 key=null, value=还有值。
但 value 是强引用,它的引用链是:Thread → ThreadLocalMap → Entry → value。只要线程还活着,这条链就断不了,value 就回收不掉。
于是产生内存泄漏:key 没了,value 还在 map 里占着内存,而且再也访问不到了。
第四问:怎么解决?线程池场景为什么更危险?
答案要点:用完必须手动 remove()。Map 的 get/set 时会顺带清理 key=null 的 entry(expungeStaleEntry),但不保证清理干净。
线程池场景更危险:线程池的线程是复用的、长期存活的,一条线程处理完任务不销毁,它持有的 value 就永远不回收。累积下来,内存泄漏会越来越严重。
四问答完,才算真正理解 ThreadLocal。 这是百度这类"深挖型"面试的通关标志——不是背"弱引用会泄漏",而是能讲清整条引用链和清理机制。
二、自动装箱拆箱:一个"送分题"里的坑
自动装箱与拆箱(高频 3/5)
题目:Java 的自动装箱与拆箱是什么?
答案要点:装箱是基本类型 → 包装类型(int → Integer,调 Integer.valueOf);拆箱反过来(调 intValue)。
追问点(百度的坑在这):Integer a = 127; Integer b = 127; a == b 是 true 还是 false?
答案:127 是 true,128 是 false。因为 Integer.valueOf 对 -128 到 127 做了缓存(IntegerCache),这个范围内的对象复用同一份,超出范围就 new 新对象。所以 127 比较的是同一个对象(true),128 是两个不同对象(false)。
这个坑很经典:基础题里藏着缓存机制。答出来说明你"看过源码",不只是"用过"。
三、项目深挖:百度爱问"架构怎么设计的"
百度二面围绕项目问得很细,典型是一个 OJ 判题系统:
题目:介绍一下你的 OJ 判题系统,架构怎么设计的?
答案要点:前后端分离,前端 Vue,后端 Spring Boot。核心模块:
—题目管理(CRUD + 测试用例)
—代码提交(在线编辑器 + 语法检查)
—判题执行(沙箱隔离——这个是重点)
—结果回显
追问点(百度必挖):
—"判题怎么保证安全?"——沙箱隔离,限制 CPU/内存/时间,防止用户代码搞破坏。
—"高并发提交怎么办?"——判题任务丢进 MQ 异步处理,判题机水平扩容。
—"判题结果怎么保证一致?"——状态机 + 幂等。
准备百度项目题,重点准备"架构设计 + 安全 + 并发"这三层。
四、AI 相关:百度的"基因题"
AI 后端接口(高频 3/5)
题目:你项目里的 AI 类后端接口,用的是哪个地方的接口?(百度真实二面问过)
答案要点:这类题考的是"你有没有真做过 AI 集成"。回答要具体:调用哪家大模型(文心一言/通义/DeepSeek)、怎么封装(HTTP + SSE 流式)、怎么做上下文管理(Redis 存会话)、怎么做限流熔断(Sentinel)。
延伸准备(百度 AI 基因,可能问):
—RAG 架构(向量化 + 检索 + 生成)
—大模型调用的工程问题(超时、重试、降级)
—怎么控制成本(Token 计费、缓存)
百度是六家里"AI 味"最重的。如果你有 AI 项目经验,一定要重点讲;如果没有,也要把"Java 怎么对接大模型"这套讲清楚——这个方向在百度是加分项。
五、百度考察侧重点总结
百度的"性格"总结:
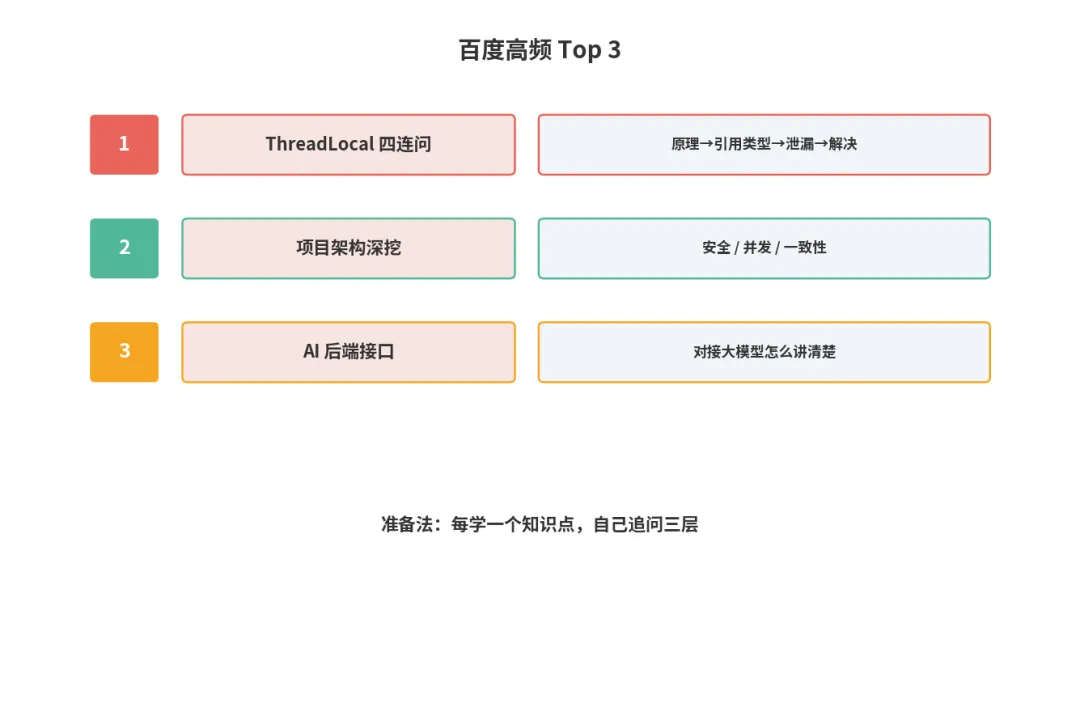
第一,深挖式提问。不是一个知识点问一句,而是"是什么→为什么→怎么实现→怎么优化"四层递进。ThreadLocal 就是标本。
第二,项目问架构。百度二面爱问"架构怎么设计的",尤其关注安全和并发。
第三,AI 是加分项。有 AI 项目经验能明显加分,没有也要懂"Java 对接大模型"的基本盘。
准备百度,抓两个重点:把 ThreadLocal、并发、JVM 这些"深挖型考点"准备到"能讲三层";把项目的技术选型和架构设计想清楚。
最后
这期是《大厂真题》第七篇。百度是"深挖型"的代表——它不考偏题,但会把基础题挖到你看没看过源码。
应对方法:准备时对自己追问三层。每学一个知识点,问自己"它是怎么实现的、为什么这么设计、有什么坑"。这三个问题答上来,百度的深挖就难不倒你。
关注我,大厂真题,一期一个厂,持续更新 🔥
本文由公众号原创 · 转载请注明出处